第三章|MP4 内部结构:从 box/atom、moov、mdat 到 stbl 采样表
拆解 MP4 的 box/atom 树、ftyp、moov、mdat、trak、stbl、fast start 和 fragmented MP4,并写一个浏览器端最小 MP4 box parser。
第三章|MP4 内部结构
1. 本章学习目标
学完这一章,你要能做到这几件事:
- 能解释 MP4 为什么是 box / atom 结构。
- 能看懂一个 MP4 文件的大体结构,比如:
ftyp
moov
  mvhd
  trak
    tkhd
    mdia
      mdhd
      hdlr
      minf
        stbl
          stsd
          stts
          stsc
          stsz
          stco / co64
          stss
mdat- 能说清楚
ftyp、moov、mdat、trak、mdia、minf、stbl分别负责什么。 - 能理解播放器是如何通过
stbl找到某个音视频 sample 的。 - 能解释 fast start MP4 为什么能边下边播。
- 能解释 普通 MP4 和 fragmented MP4 的区别。
- 能写一个浏览器端最小 MP4 box parser,打印顶层 box 列表。
本章速览
读 MP4 时,不要把它想成一整坨视频数据,而要先把它看成“目录 + 索引 + 正文数据”:
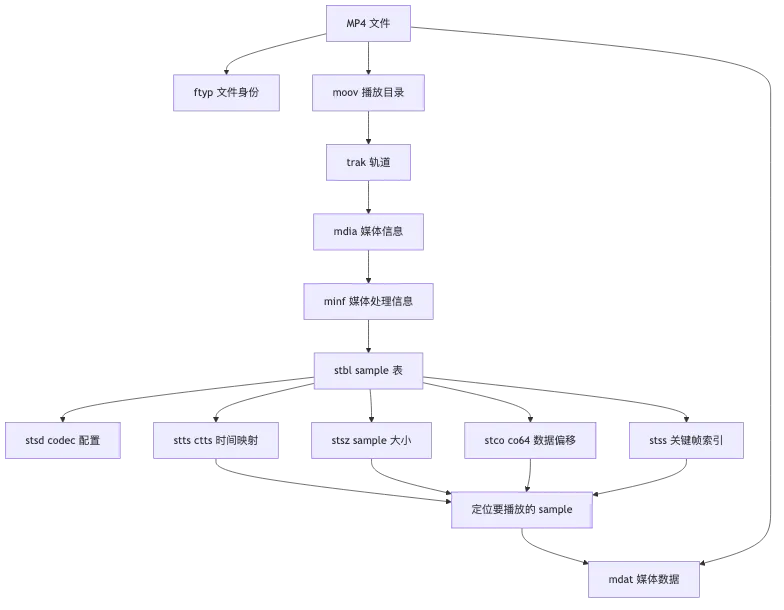
本章的核心总结:
ftyp说明文件兼容性,moov存播放所需的元数据和索引,mdat存真正的编码后媒体数据。- 播放器 seek 或播放时,通常先读
moov里的stbl,再按时间、大小和 offset 到mdat取 sample。 - fast start 的关键是把
moov放到前面,让播放器不必下载完整文件就能拿到播放目录。
2. 先建立心智模型:MP4 不是一坨视频数据
很多新人以为 MP4 文件里面就是:
视频数据 + 音频数据但真实的 MP4 更像一个“带目录的仓库”:
MP4 文件
├── 文件身份说明
├── 播放目录 / 元数据
├── 视频轨道信息
├── 音频轨道信息
├── 每个 sample 的时间、大小、位置索引
└── 真正的媒体数据
MP4 属于 ISO Base Media File Format 这一类文件格式。这个家族的文件是由一系列 box 组成的,box 也常被叫作 atom;每个 box 有自己的大小和四字符类型,box 里面还可以继续嵌套 box。MP4 Registration Authority 对这类 box/atom 的注册类型也有公开列表。(MP4RA)
可以把 MP4 想象成一本书:
| MP4 部分 | 类比成一本书 |
|---|---|
ftyp | 书的版本说明:这本书按什么规范写 |
moov | 目录、章节结构、页码索引 |
trak | 一本书里的不同章节线,比如视频轨、音频轨 |
stbl | 页码索引表:第几段内容在哪一页,从哪里开始 |
mdat | 正文内容本身 |
free | 空白页、预留空间 |
重点是:播放器不是从头到尾盲读 mdat,而是先读 moov 里的索引,再去 mdat 里按位置取数据。
3. MP4 的 box / atom 基本格式
一个普通 box 的基本结构是:
+------------------+
| size   4 bytes   |
+------------------+
| type   4 bytes   |
+------------------+
| data   N bytes   |
+------------------+
也就是:
[size][type][payload]其中:
| 字段 | 含义 |
|---|---|
size | 当前 box 的总长度,包含 size 字段、type 字段和 payload |
type | 四字符类型,比如 ftyp、moov、mdat |
payload | box 里面真正的数据,可能是普通字段,也可能继续嵌套子 box |
例如一个 box 的开头字节可能表示:
00 00 00 18 66 74 79 70 ...解释一下:
00 00 00 18  => size = 24 字节
66 74 79 70  => ASCII 字符 "ftyp"
所以这是一个大小为 24 字节的 ftyp box。
特殊情况有两个:
| size 值 | 含义 |
|---|---|
size = 1 | 使用 64-bit largesize,真实大小在后面 8 字节 |
size = 0 | 当前 box 一直延伸到文件末尾,常见于某些 mdat |
实际写 parser 的时候,最少要处理 size = 1。size = 0 在简单练习里可以先识别出来,不一定完整支持。
4. 顶层 box:MP4 文件的大骨架
一个普通 MP4 文件常见的顶层结构是:
MP4 file
├── ftyp
├── free       可选
├── moov
└── mdat
或者:
MP4 file
├── ftyp
├── mdat
└── moov
第二种就是很多非 fast start 文件的结构:moov 在 mdat 后面。
MP4RA 注册表里把 ftyp 描述为 file type and compatibility,moov 描述为 metadata 容器,mdat 描述为 media data container。(MP4RA)
5. 常见顶层 box
5.1 ftyp:File Type Box
ftyp 通常在文件开头,用来声明这个文件的品牌和兼容性。
它大概包含:
major_brand
minor_version
compatible_brands[]
例如:
major_brand: isom
compatible_brands: isom, iso2, avc1, mp41
你可以粗略理解成:
这个 MP4 文件声称自己符合哪些 MP4 / ISO BMFF 相关规范或变体。
这对播放器很重要。播放器看到 ftyp 后,会判断:
- 我是否认识这个 major brand?
- 我是否支持 compatible brands 里面声明的格式?
- 后面的 box 是否应该按某种规范解释?
但要注意:ftyp 只告诉你“容器层面”的兼容性,并不等于浏览器一定能解码里面的视频编码。
例如:
video/mp4; codecs="avc1.42E01E, mp4a.40.2"这里 video/mp4 是容器 MIME 类型,avc1... 和 mp4a... 才是在描述视频、音频编码相关信息。
5.2 moov:Movie Box
moov 是 MP4 里最关键的元数据 box。
它通常包含:
moov
├── mvhd
├── trak
├── trak
└── ...
moov 不主要放媒体原始数据,而是放:
- 整个文件的时长。
- 有几条轨道。
- 每条轨道是视频、音频还是字幕。
- 每个 sample 的时间信息。
- 每个 sample 的大小。
- 每个 sample 在
mdat中的位置。 - 哪些 sample 是关键帧。
- 解码器初始化信息,比如 H.264 的 SPS/PPS、AAC 的 AudioSpecificConfig。
可以把 moov 理解成:
播放器播放 MP4 前必须看的“地图”。
没有 moov,播放器就算拿到了 mdat 里的媒体数据,也很难知道这些字节应该怎么切分、怎么排序、什么时候播放、用什么解码器解码。
5.3 mdat:Media Data Box
mdat 是真正存放媒体数据的地方。
里面通常会放:
视频 sample
音频 sample
视频 sample
音频 sample
...
但 mdat 自己一般不告诉你:
- 哪一段是一个 sample。
- sample 属于视频轨还是音频轨。
- sample 的时间戳是多少。
- sample 是否是关键帧。
- sample 应该送给哪个 decoder。
这些信息主要在 moov -> trak -> mdia -> minf -> stbl 里面。
所以你可以这样理解:
mdat = 仓库里的货物
moov = 仓库管理系统
stbl = 货架索引表
播放器真正取数据时,通常是:
先读 moov/stbl 找索引
再去 mdat 按 byte offset 取 sample
5.4 free:Free Space Box
free 是预留空间。
它的作用通常是:
- 给后续修改元数据留空间。
- 对齐文件布局。
- 被播放器忽略。
例如有些工具会在文件里插入 free box,这样之后改 metadata 的时候,不一定要重写整个文件。
6. moov 内部结构:MP4 的“播放说明书”
一个典型 moov 结构如下:
moov
├── mvhd
├── trak
│   ├── tkhd
│   └── mdia
│       ├── mdhd
│       ├── hdlr
│       └── minf
│           ├── vmhd / smhd
│           ├── dinf
│           └── stbl
│               ├── stsd
│               ├── stts
│               ├── stsc
│               ├── stsz
│               ├── stco / co64
│               └── stss
└── trak
    ├── tkhd
    └── mdia
        ├── mdhd
        ├── hdlr
        └── minf
            ├── smhd / vmhd
            ├── dinf
            └── stbl
                ├── stsd
                ├── stts
                ├── stsc
                ├── stsz
                ├── stco / co64
                └── stss
如果一个 MP4 有视频和音频,通常会有两个 trak:
trak #1: video
trak #2: audio
当然也可能有字幕轨、metadata 轨、hint track 等。
7. mvhd:Movie Header Box
mvhd 是整个 movie 级别的头信息。
它通常描述:
| 信息 | 含义 |
|---|---|
timescale | 整个 movie 的时间单位 |
duration | 整个 movie 的持续时间 |
creation_time | 创建时间 |
modification_time | 修改时间 |
next_track_ID | 下一个可用 track ID |
timescale 是 MP4 里非常重要的概念。
例如:
timescale = 1000
duration = 60000
表示:
duration 秒数 = 60000 / 1000 = 60 秒注意:movie 有自己的 timescale,每个 track 也可以有自己的 timescale。
8. trak:Track Box
一个 trak 表示一条媒体轨道。
常见轨道有:
| 轨道类型 | 说明 |
|---|---|
| video track | 视频轨 |
| audio track | 音频轨 |
| subtitle track | 字幕轨 |
| metadata track | 元数据轨 |
例如一个常规 MP4:
moov
├── trak  视频轨
└── trak  音频轨
每条 trak 都有自己的时间轴、sample 表、编码信息和媒体数据引用。
重点是:trak 是逻辑轨道,不是说它内部直接塞满视频字节或音频字节。真正的数据一般在 mdat 里。
9. tkhd:Track Header Box
tkhd 是 track 级别的头信息。
它描述这一条轨道的整体属性:
| 字段 | 作用 |
|---|---|
track_ID | 当前轨道 ID |
duration | 当前轨道持续时间 |
width | 视频轨宽度 |
height | 视频轨高度 |
volume | 音频轨音量 |
| flags | 轨道是否启用、是否在 movie 中展示等 |
如果是视频轨,tkhd 里通常能看到宽高信息。
例如:
width = 1920
height = 1080
如果是音频轨,宽高没有意义,但可能会关心 volume。
10. mdia:Media Box
mdia 是 track 里的媒体信息容器。
它通常包含:
mdia
├── mdhd
├── hdlr
└── minf
MP4RA 把 mdia 描述为 track 中媒体信息的容器,把 mdhd 描述为媒体整体信息。(MP4RA)
你可以这样理解:
trak = 这是一条轨道
mdia = 这条轨道具体是什么媒体,时间怎么走,数据怎么组织
11. mdhd:Media Header Box
mdhd 是 media 级别的头信息。
它通常包含:
| 信息 | 含义 |
|---|---|
timescale | 当前 track 的时间单位 |
duration | 当前 track 的持续时间 |
language | 语言信息 |
例如音频轨可能是:
timescale = 48000
duration = 2880000
表示:
2880000 / 48000 = 60 秒视频轨可能是:
timescale = 90000
duration = 5400000
也表示:
5400000 / 90000 = 60 秒这就是为什么你不能看到一个 duration 数字就直接当秒数,必须结合当前 box 的 timescale。
12. hdlr:Handler Reference Box
hdlr 用来声明这条 track 是什么类型。
常见 handler type:
| handler type | 含义 |
|---|---|
vide | 视频轨 |
soun | 音频轨 |
subt | 字幕轨 |
meta | 元数据轨 |
例如:
trak
└── mdia
    └── hdlr: vide
说明这是一条视频轨。
trak
└── mdia
    └── hdlr: soun
说明这是一条音频轨。
hdlr 在工程里非常好用:你写 MP4 parser 时,可以靠它判断某个 trak 是视频还是音频。
13. minf:Media Information Box
minf 是媒体信息容器。
它通常包含:
minf
├── vmhd / smhd
├── dinf
└── stbl
不同 track 类型会有不同的 media header:
| box | 用于 |
|---|---|
vmhd | video media header |
smhd | sound media header |
hmhd | hint media header |
sthd | subtitle media header |
不过对我们前端工程师来说,最关键的是:
minf -> stbl因为 stbl 里面放的是 sample table,也就是播放器找 sample 的核心索引。
14. stbl:Sample Table Box
stbl 是这一章最重要的 box。
MP4RA 把 stbl 描述为 sample table box,是 time/space map 的容器;其中 stsd 记录 sample description,stts 记录 decoding time-to-sample,stsc 记录 sample-to-chunk,stsz 记录 sample size,stco 记录 chunk offset,stss 记录同步 sample,也就是随机访问点。(MP4RA)
这句话翻成人话就是:
stbl告诉播放器:每个 sample 什么时候解码、大小是多少、在哪个文件偏移、用什么解码器、哪些地方可以安全 seek。
一个典型 stbl:
stbl
├── stsd    sample 描述:codec、初始化参数
├── stts    解码时间表
├── ctts    显示时间偏移表,可选,B 帧相关
├── stsc    sample 到 chunk 的映射
├── stsz    每个 sample 的大小
├── stco    每个 chunk 的文件偏移,32-bit
├── co64    每个 chunk 的文件偏移,64-bit
└── stss    关键帧 / 同步 sample 表
这一块刚开始会觉得绕。你可以用一句话记:
stsd 解决“怎么解”
stts 解决“什么时候解”
ctts 解决“什么时候显示”
stsz 解决“每个 sample 多大”
stsc 解决“sample 怎么装进 chunk”
stco/co64 解决“chunk 在文件哪里”
stss 解决“哪里可以 seek”
15. stsd:Sample Description Box
stsd 说明这条 track 的 sample 应该用什么格式解析和解码。
对视频轨来说,里面可能出现:
avc1
avc3
hvc1
hev1
av01
vp09
对音频轨来说,里面可能出现:
mp4a
Opus
例如 H.264 视频经常是:
stsd
└── avc1
    └── avcC
其中:
| box | 含义 |
|---|---|
avc1 | H.264/AVC sample entry |
avcC | AVC Decoder Configuration Record,包含 SPS/PPS 等初始化信息 |
这对 WebCodecs 非常重要。你之后用 VideoDecoder.configure() 时,需要构造:
const config: VideoDecoderConfig = {
  codec: "avc1.42E01E",
  description: avcCBytes,
};
其中 description 很可能就来自 MP4 的 avcC。
所以,stsd 是连接 MP4 容器和 decoder 的关键桥梁。
16. stts:Time To Sample Box
stts 记录 sample 的解码时间间隔。
它不是简单地列出每个 sample 的时间戳,而是用压缩表的方式记录:
sample_count
sample_delta
例如:
entry_count = 1
sample_count = 300
sample_delta = 3000
假设 track timescale 是 90000,那么:
每个 sample 间隔 = 3000 / 90000 = 1/30 秒也就是 30fps。
解码时间 DTS 可以这样累计:
sample 1 DTS = 0
sample 2 DTS = 3000
sample 3 DTS = 6000
sample 4 DTS = 9000
...注意:stts 描述的是 decoding time,也就是解码时间,不一定等于显示时间。
为什么?因为视频里可能有 B 帧。
17. ctts:Composition Time To Sample Box
虽然你的大纲没有强制要求 ctts,但面试和真实工程里很容易碰到,所以这里顺带讲一下。
ctts 记录的是:
composition time offset也就是:
PTS = DTS + composition_offset其中:
| 时间戳 | 含义 |
|---|---|
| DTS | Decoding Timestamp,什么时候送去解码 |
| PTS | Presentation Timestamp,什么时候显示 |
| composition offset | PTS 和 DTS 的差值 |
如果视频没有 B 帧,DTS 和 PTS 可能一样。
如果视频有 B 帧,编码顺序和显示顺序可能不同:
显示顺序: I B B P
解码顺序: I P B B
这时就需要 ctts 告诉播放器每帧真正显示的时间。
WebCodecs 里你会经常看到 timestamp,理解 DTS / PTS 后会轻松很多。
18. stsc:Sample To Chunk Box
MP4 不是直接说:
sample 1 在文件 offset 100
sample 2 在文件 offset 500
sample 3 在文件 offset 900
而是引入了 chunk。
简单理解:
sample = 一帧视频,或一小段音频
chunk = 一组连续 sample
stsc 负责说明:
哪些 sample 属于哪个 chunk
每个 chunk 有多少 sample
例如:
chunk 1: sample 1, sample 2, sample 3
chunk 2: sample 4, sample 5, sample 6
chunk 3: sample 7, sample 8, sample 9
那 stsc 就会描述 sample 和 chunk 的映射关系。
为什么要有 chunk?
因为这样可以减少 offset 表的大小。文件只需要记录每个 chunk 的起始位置,再结合每个 sample 的大小,就可以推算 chunk 内每个 sample 的位置。
19. stsz:Sample Size Box
stsz 记录每个 sample 的大小。MP4RA 对 stsz 的描述就是 sample sizes,也就是 framing 信息。(MP4RA)
例如:
sample 1 size = 15342 bytes
sample 2 size = 1201 bytes
sample 3 size = 970 bytes
sample 4 size = 4812 bytes
对视频来说:
一个 sample 通常可以理解为一帧压缩后的视频数据对音频来说:
一个 sample 通常可以理解为一个音频访问单元,比如 AAC frame有了 stsz,播放器才知道从 mdat 里切多少字节出来交给 decoder。
20. stco / co64:Chunk Offset Box
stco 或 co64 记录 chunk 在文件里的偏移位置。
区别是:
| box | 偏移大小 |
|---|---|
stco | 32-bit chunk offset |
co64 | 64-bit chunk offset |
MP4RA 注册表里也把 co64 描述为 64-bit chunk offset,把 stco 描述为 chunk offset / partial data-offset information。(MP4RA)
为什么需要 co64?
因为大文件可能超过 4GB,32-bit offset 不够用。
有了:
stco / co64: chunk 起点
stsc: sample 属于哪个 chunk
stsz: 每个 sample 大小
播放器就可以推导出每个 sample 的真实文件位置。
21. stss:Sync Sample Box
stss 记录哪些 sample 是同步点,也就是常说的关键帧位置。MP4RA 把 stss 描述为 sync sample table,也就是 random access points。(MP4RA)
对视频来说,stss 通常对应可以随机访问的帧,比如 I 帧 / IDR 帧。
为什么重要?
因为 seek 的时候不能随便跳到任意 P 帧或 B 帧。比如你拖动进度条到第 60 秒,播放器通常会:
1. 找到 60 秒附近之前最近的关键帧
2. 从那个关键帧开始解码
3. 解码到目标时间
4. 再显示目标画面
所以如果没有 stss,播放器 seek 会很痛苦。
22. 通过 stbl 找到 sample:完整推导过程
假设我们要找视频轨的第 100 个 sample。
播放器大概需要这些表:
stts  -> 知道第 100 个 sample 的 DTS
ctts  -> 如果存在,计算 PTS
stss  -> 判断是不是关键帧,或者 seek 时找最近关键帧
stsc  -> 知道第 100 个 sample 属于哪个 chunk
stco  -> 知道这个 chunk 在文件里的起始 offset
stsz  -> 知道 chunk 内前面 sample 的大小,以及第 100 个 sample 自己的大小
stsd  -> 知道这个 sample 要送给哪个 decoder,以及 decoder config
简化推导:
目标:找到 sample #100 的文件偏移和大小

1. 用 stsc 找到 sample #100 属于 chunk #12
2. 用 stco/co64 找到 chunk #12 的起点 offset
3. 用 stsz 累加 chunk 内 sample #100 前面的 sample size
4. 得到 sample #100 的真实 offset
5. 用 stsz 得到 sample #100 的 size
6. 从 mdat 里读取 [offset, offset + size)
7. 用 stsd 里的 codec 信息配置 decoder
8. 用 stts/ctts 给这个 sample 计算 timestamp
9. 把 sample 喂给 decoder
文字流程图:
用户点击播放 / seek
        ↓
读取 moov
        ↓
找到 video trak / audio trak
        ↓
进入 mdia / minf / stbl
        ↓
读取 stsd:确定 codec 和初始化参数
        ↓
读取 stts / ctts:计算时间戳
        ↓
读取 stss:找关键帧
        ↓
读取 stsc:sample -> chunk
        ↓
读取 stco/co64:chunk -> 文件 offset
        ↓
读取 stsz:sample size
        ↓
从 mdat 中切出 sample bytes
        ↓
送入 decoder
        ↓
渲染视频帧 / 播放音频
23. MP4 文件结构树
普通 MP4 可以记成这棵树:
MP4
├── ftyp
│   ├── major_brand
│   ├── minor_version
│   └── compatible_brands
│
├── moov
│   ├── mvhd
│   │
│   ├── trak
│   │   ├── tkhd
│   │   └── mdia
│   │       ├── mdhd
│   │       ├── hdlr
│   │       └── minf
│   │           ├── vmhd / smhd
│   │           ├── dinf
│   │           └── stbl
│   │               ├── stsd
│   │               ├── stts
│   │               ├── ctts
│   │               ├── stsc
│   │               ├── stsz
│   │               ├── stco / co64
│   │               └── stss
│   │
│   └── trak
│       ├── tkhd
│       └── mdia
│           ├── mdhd
│           ├── hdlr
│           └── minf
│               ├── vmhd / smhd
│               ├── dinf
│               └── stbl
│                   ├── stsd
│                   ├── stts
│                   ├── ctts
│                   ├── stsc
│                   ├── stsz
│                   ├── stco / co64
│                   └── stss
│
├── free
│
└── mdat
    └── media samples
24. 播放器读取 MP4 的流程
播放器播放一个普通 MP4,大概是这样:
1. 读取文件开头
2. 解析 ftyp
3. 判断容器品牌是否支持
4. 寻找 moov
5. 解析 mvhd,获得整体时长等信息
6. 遍历 trak
7. 通过 hdlr 判断 video track / audio track
8. 读取每条 track 的 mdhd,获得 timescale 和 duration
9. 读取 stsd,拿到 codec 和 decoder config
10. 读取 stbl 中的时间表、大小表、偏移表
11. 根据 sample table 从 mdat 中取出 sample
12. 把 sample 送给音频或视频 decoder
13. 根据时间戳同步音视频
14. 渲染视频帧,播放音频帧
换成 Web 侧视角:
fetch MP4 bytes
        ↓
parse boxes
        ↓
find moov
        ↓
parse tracks
        ↓
extract codec config
        ↓
build EncodedVideoChunk / EncodedAudioChunk
        ↓
VideoDecoder / AudioDecoder
        ↓
VideoFrame / AudioData
        ↓
Canvas / Web Audio
当然,真实浏览器内部播放器比这个复杂得多,但主干思路就是这样。
25. Fast Start MP4 是什么?
普通 MP4 可能长这样:
ftyp
mdat
moov
这对本地播放没什么问题,因为播放器可以随机访问文件末尾,找到 moov。
但对网络播放不友好。
假设一个 1GB 的 MP4 文件,moov 在最后:
ftyp |---------------- mdat 巨大数据 ----------------| moov浏览器要播放前,必须先拿到 moov。如果 moov 在文件末尾,播放器可能需要额外发起 range request 去文件尾部找元数据,或者等下载很多数据之后才能开始播放。
Fast start MP4 会把 moov 放到 mdat 前面:
ftyp
moov
mdat
这样播放器一开始就能拿到索引信息,然后边下载 mdat 边播放。
所以 fast start 的核心是:
把 moov 移到 mdat 前面
并修正 stco/co64 里的 chunk offset
为什么要修正 offset?
因为 moov 原来在文件尾部,现在被移动到前面,mdat 的位置发生了变化。stco / co64 记录的是媒体数据的文件偏移,因此必须整体重算。
可以用 FFmpeg 生成 fast start MP4:
ffmpeg -i input.mp4 -c copy -movflags +faststart output.mp4面试里可以这样回答:
Fast start MP4 是把
moovbox 放在mdat前面,让播放器能尽早拿到元数据和 sample 索引,从而支持渐进式下载播放。移动moov后,需要修正stco或co64里的 chunk offset。
26. Fragmented MP4 是什么?
普通 MP4 通常是:
ftyp
moov
mdat
或者:
ftyp
mdat
moov
它的特点是:
moov 里有完整 sample table
mdat 里有完整媒体数据
Fragmented MP4,简称 fMP4,会把媒体数据拆成多个 fragment:
ftyp
moov
moof
mdat
moof
mdat
moof
mdat
...
mfra
其中:
| box | 含义 |
|---|---|
moof | Movie Fragment Box,描述一个媒体片段 |
mdat | 当前 fragment 对应的媒体数据 |
mfra | Movie Fragment Random Access,辅助随机访问,可选,常在文件末尾 |
W3C 的 ISO BMFF byte stream 说明中,把初始化段定义为 ftyp 后跟 moov;媒体段则可以是可选的 styp,后跟一个 moof 和一个或多个 mdat。这正是浏览器 MSE 场景里常见的 fMP4 分段模型。(W3C)
普通 MP4 和 fragmented MP4 的区别可以这样记:
| 对比项 | 普通 MP4 | Fragmented MP4 |
|---|---|---|
| 文件结构 | ftyp + moov + mdat | ftyp + moov + moof/mdat... |
| 元数据位置 | 主要集中在 moov | 初始化信息在 moov,片段信息在每个 moof |
| sample table | 通常在 moov -> stbl 里比较完整 | 每个 fragment 有自己的 sample 信息 |
| 适合场景 | 本地播放、普通点播文件 | MSE、DASH、HLS fMP4、低延迟流式播放 |
| 是否便于分段传输 | 一般 | 很适合 |
| 浏览器 MSE | 不是主流追加格式 | 常见追加格式 |
fMP4 的典型结构
fragmented.mp4
├── ftyp
├── moov
│   ├── mvhd
│   ├── trak
│   │   └── ...
│   └── mvex
│
├── moof
│   ├── mfhd
│   └── traf
│       ├── tfhd
│       ├── tfdt
│       └── trun
├── mdat
│
├── moof
│   ├── mfhd
│   └── traf
│       ├── tfhd
│       ├── tfdt
│       └── trun
├── mdat
│
└── mfra
moof 里面有什么?
moof 是一个 fragment 的元数据。
它通常包含:
moof
├── mfhd
└── traf
    ├── tfhd
    ├── tfdt
    └── trun
简单说:
| box | 作用 |
|---|---|
mfhd | movie fragment header |
traf | track fragment |
tfhd | track fragment header |
tfdt | 当前 fragment 的 decode time 起点 |
trun | 当前 fragment 中 sample 的大小、时长、flags、数据偏移等 |
普通 MP4 里很多信息在 stbl,fMP4 里每个片段自己的 sample 信息会更多地放在 trun 等 fragment box 里。
27. 普通 MP4 vs fMP4:用一句话讲清楚
普通 MP4:
先给你一本完整目录,再给你整本书正文。Fragmented MP4:
先给你全书基本说明,然后每发一章,就附带这一章的小目录和正文。所以 fMP4 更适合流式传输:
初始化段:
ftyp + moov

媒体段:
moof + mdat
moof + mdat
moof + mdat
...
这也是为什么 MSE 里常见代码会这样:
sourceBuffer.appendBuffer(initSegment);
sourceBuffer.appendBuffer(mediaSegment1);
sourceBuffer.appendBuffer(mediaSegment2);
sourceBuffer.appendBuffer(mediaSegment3);
28. 和真实工程的关系
28.1 WebCodecs
如果你用 WebCodecs 手写 MP4 解码 Demo,大致要做:
1. 解析 MP4 box
2. 找到 moov
3. 找到视频 trak
4. 解析 stsd,拿到 codec 和 description
5. 解析 stts / ctts / stsc / stsz / stco / stss
6. 从 mdat 切出每个 encoded sample
7. 构造 EncodedVideoChunk
8. 送给 VideoDecoder.decode()
9. 得到 VideoFrame
10. 画到 Canvas
伪代码:
const decoder = new VideoDecoder({
  output(frame) {
    // draw frame to canvas
    frame.close();
  },
  error(error) {
    console.error(error);
  },
});

decoder.configure({
  codec: "avc1.42E01E",
  description: avcCBytes,
});

for (const sample of samples) {
  decoder.decode(new EncodedVideoChunk({
    type: sample.isKeyframe ? "key" : "delta",
    timestamp: sample.pts,
    duration: sample.duration,
    data: sample.bytes,
  }));
}
注意:这只是主流程。真实处理 H.264 in MP4 时还会涉及 AVCC 格式、Annex B 格式、NALU length size、SPS/PPS 等问题,后面 WebCodecs 章节再展开。
28.2 MSE
如果你做播放器,尤其是 HLS / DASH / fMP4,常见流程是:
1. fetch init segment
2. append 到 SourceBuffer
3. fetch media segment
4. append 到 SourceBuffer
5. 浏览器内部 demux + decode + render
代码轮廓:
const mediaSource = new MediaSource();
video.src = URL.createObjectURL(mediaSource);

mediaSource.addEventListener("sourceopen", async () => {
  const sourceBuffer = mediaSource.addSourceBuffer(
    'video/mp4; codecs="avc1.42E01E, mp4a.40.2"'
  );

  const initSegment = await fetchArrayBuffer("/init.mp4");
  sourceBuffer.appendBuffer(initSegment);

  sourceBuffer.addEventListener("updateend", async () => {
    const segment = await fetchArrayBuffer("/segment-1.m4s");
    sourceBuffer.appendBuffer(segment);
  }, { once: true });
});

async function fetchArrayBuffer(url: string): Promise<ArrayBuffer> {
  const res = await fetch(url);
  if (!res.ok) {
    throw new Error(`fetch failed: ${res.status}`);
  }
  return res.arrayBuffer();
}
这里你不一定自己解析每个 sample,因为浏览器内部会处理;但你必须理解:
init segment = ftyp + moov
media segment = moof + mdat
否则遇到 MSE append 报错时会完全摸不着头脑。
28.3 前端上传 / 转码 / 预览
在业务里,你可能会遇到:
- 用户上传 MP4 后,浏览器迟迟不能预览。
- 后端转出来的视频不能边下边播。
- 某些 MP4 Safari 能播,Chrome 不能播。
- 视频能播但拖动进度条很慢。
- MSE appendBuffer 报 decode error。
- WebCodecs configure 失败。
很多时候排查方向就是:
1. moov 在 mdat 前还是后?
2. ftyp / codec string 是否正确?
3. stsd 里的 codec 配置是否完整?
4. stco/co64 offset 是否正确?
5. stss 关键帧表是否合理?
6. fMP4 是否符合 init segment + media segment 的结构?
29. 常见误区
误区 1:mdat 里面有完整播放信息
不对。
mdat 主要放媒体数据,播放所需的时间、大小、位置、codec、关键帧等信息主要在 moov / stbl。
误区 2:MP4 一定能边下边播
不一定。
如果 moov 在 mdat 后面,播放器可能需要先拿到文件尾部元数据,体验会变差。
误区 3:moov 只是普通 metadata,可有可无
不对。
moov 是播放器理解文件结构的核心。没有 moov,通常无法正常播放。
误区 4:一个 trak 就等于一段连续的二进制数据
不对。
trak 是逻辑轨道。真正的 sample 数据通常在 mdat 里,不同 track 的 sample 可能交错存放。
误区 5:stco 可以随便改
不行。
stco / co64 是文件偏移索引。如果移动了 moov、插入了 box、重排了 mdat,都可能导致 offset 失效。
误区 6:fMP4 就是把 MP4 切成几段
不准确。
fMP4 不只是物理切文件,而是有明确的 fragment 结构。每个媒体段通常有自己的 moof 描述对应的 mdat。
30. 实践任务一:读取 MP4 前几十 KB
浏览器端 HTML:
<input id="fileInput" type="file" accept="video/mp4" />
<pre id="output"></pre>

<script type="module">
  const input = document.querySelector("#fileInput");
  const output = document.querySelector("#output");

  input.addEventListener("change", async () => {
    const file = input.files?.[0];
    if (!file) return;

    const chunk = file.slice(0, 64 * 1024);
    const buffer = await chunk.arrayBuffer();

    const bytes = new Uint8Array(buffer.slice(0, 64));
    output.textContent = Array.from(bytes)
      .map(byte => byte.toString(16).padStart(2, "0"))
      .join(" ");
  });
</script>
你可以观察前几个字节,很可能会看到:
00 00 00 xx 66 74 79 70也就是:
size + "ftyp"31. 实践任务二:写最小 MP4 box parser
下面这个 parser 只解析:
offset
size
type
它不深入解析每个 box 的内部字段,但足够打印顶层 box 列表。
TypeScript 版本
type Mp4Box = {
  offset: number;
  size: number;
  headerSize: number;
  type: string;
};

function readUint32(view: DataView, offset: number): number {
  return view.getUint32(offset, false); // big-endian
}

function readUint64(view: DataView, offset: number): number {
  const high = view.getUint32(offset, false);
  const low = view.getUint32(offset + 4, false);

  const value = high * 2 ** 32 + low;

  if (!Number.isSafeInteger(value)) {
    throw new Error(`uint64 value is not safe integer: ${value}`);
  }

  return value;
}

function readType(view: DataView, offset: number): string {
  return String.fromCharCode(
    view.getUint8(offset),
    view.getUint8(offset + 1),
    view.getUint8(offset + 2),
    view.getUint8(offset + 3),
  );
}

function parseTopLevelBoxes(buffer: ArrayBuffer): Mp4Box[] {
  const view = new DataView(buffer);
  const boxes: Mp4Box[] = [];

  let offset = 0;

  while (offset + 8 <= buffer.byteLength) {
    const start = offset;
    const size32 = readUint32(view, offset);
    const type = readType(view, offset + 4);

    offset += 8;

    let size: number;
    let headerSize = 8;

    if (size32 === 1) {
      if (offset + 8 > buffer.byteLength) {
        throw new Error(`Invalid largesize box at offset ${start}`);
      }

      size = readUint64(view, offset);
      offset += 8;
      headerSize = 16;
    } else if (size32 === 0) {
      size = buffer.byteLength - start;
    } else {
      size = size32;
    }

    if (size < headerSize) {
      throw new Error(
        `Invalid box size at offset ${start}: size=${size}, type=${type}`
      );
    }

    if (start + size > buffer.byteLength) {
      // 如果你只读取了文件前几十 KB,可能会遇到 mdat 没读完整。
      boxes.push({
        offset: start,
        size,
        headerSize,
        type,
      });

      break;
    }

    boxes.push({
      offset: start,
      size,
      headerSize,
      type,
    });

    offset = start + size;
  }

  return boxes;
}
32. 实践任务三:浏览器页面打印顶层 box
<input id="fileInput" type="file" accept="video/mp4" />
<pre id="output"></pre>

<script type="module">
  const input = document.querySelector("#fileInput");
  const output = document.querySelector("#output");

  input.addEventListener("change", async () => {
    const file = input.files?.[0];
    if (!file) return;

    const buffer = await file.arrayBuffer();
    const boxes = parseTopLevelBoxes(buffer);

    output.textContent = boxes
      .map(box => {
        return `${box.type} offset=${box.offset} size=${box.size}`;
      })
      .join("\n");

    const moov = boxes.find(box => box.type === "moov");
    const mdat = boxes.find(box => box.type === "mdat");

    if (moov && mdat) {
      output.textContent += "\n\n";
      output.textContent += moov.offset < mdat.offset
        ? "moov 在 mdat 前:可能是 fast start MP4"
        : "moov 在 mdat 后:不是典型 fast start MP4";
    }
  });

  function readUint32(view, offset) {
    return view.getUint32(offset, false);
  }

  function readUint64(view, offset) {
    const high = view.getUint32(offset, false);
    const low = view.getUint32(offset + 4, false);
    const value = high * 2 ** 32 + low;

    if (!Number.isSafeInteger(value)) {
      throw new Error(`uint64 value is not safe integer: ${value}`);
    }

    return value;
  }

  function readType(view, offset) {
    return String.fromCharCode(
      view.getUint8(offset),
      view.getUint8(offset + 1),
      view.getUint8(offset + 2),
      view.getUint8(offset + 3),
    );
  }

  function parseTopLevelBoxes(buffer) {
    const view = new DataView(buffer);
    const boxes = [];

    let offset = 0;

    while (offset + 8 <= buffer.byteLength) {
      const start = offset;
      const size32 = readUint32(view, offset);
      const type = readType(view, offset + 4);

      offset += 8;

      let size;
      let headerSize = 8;

      if (size32 === 1) {
        if (offset + 8 > buffer.byteLength) {
          throw new Error(`Invalid largesize box at offset ${start}`);
        }

        size = readUint64(view, offset);
        offset += 8;
        headerSize = 16;
      } else if (size32 === 0) {
        size = buffer.byteLength - start;
      } else {
        size = size32;
      }

      if (size < headerSize) {
        throw new Error(
          `Invalid box size at offset ${start}: size=${size}, type=${type}`
        );
      }

      boxes.push({
        offset: start,
        size,
        headerSize,
        type,
      });

      offset = start + size;
    }

    return boxes;
  }
</script>
你可以拿不同 MP4 试一下,可能看到类似:
ftyp offset=0 size=32
free offset=32 size=8
mdat offset=40 size=103482933
moov offset=103482973 size=38420

moov 在 mdat 后:不是典型 fast start MP4
或者:
ftyp offset=0 size=32
moov offset=32 size=38420
free offset=38452 size=8
mdat offset=38460 size=103482933

moov 在 mdat 前:可能是 fast start MP4
33. 实践任务四:递归打印 box 树
上面的 parser 只打印顶层 box。下一步可以递归解析容器 box。
常见容器 box:
const CONTAINER_BOXES = new Set([
  "moov",
  "trak",
  "mdia",
  "minf",
  "stbl",
  "edts",
  "dinf",
  "moof",
  "traf",
  "mfra",
]);
简化代码:
type Mp4BoxNode = {
  offset: number;
  size: number;
  headerSize: number;
  type: string;
  children?: Mp4BoxNode[];
};

const CONTAINER_BOXES = new Set([
  "moov",
  "trak",
  "mdia",
  "minf",
  "stbl",
  "edts",
  "dinf",
  "moof",
  "traf",
  "mfra",
]);

function parseBoxes(
  view: DataView,
  start: number,
  end: number,
): Mp4BoxNode[] {
  const boxes: Mp4BoxNode[] = [];
  let offset = start;

  while (offset + 8 <= end) {
    const boxStart = offset;
    const size32 = readUint32(view, offset);
    const type = readType(view, offset + 4);

    offset += 8;

    let size: number;
    let headerSize = 8;

    if (size32 === 1) {
      size = readUint64(view, offset);
      offset += 8;
      headerSize = 16;
    } else if (size32 === 0) {
      size = end - boxStart;
    } else {
      size = size32;
    }

    if (size < headerSize) {
      throw new Error(`Invalid box size: ${type} at ${boxStart}`);
    }

    const boxEnd = boxStart + size;

    if (boxEnd > end) {
      throw new Error(`Box ${type} exceeds parent range`);
    }

    const node: Mp4BoxNode = {
      offset: boxStart,
      size,
      headerSize,
      type,
    };

    if (CONTAINER_BOXES.has(type)) {
      node.children = parseBoxes(view, boxStart + headerSize, boxEnd);
    }

    boxes.push(node);
    offset = boxEnd;
  }

  return boxes;
}

function printBoxTree(boxes: Mp4BoxNode[], indent = 0): string {
  return boxes
    .map(box => {
      const line = `${" ".repeat(indent)}${box.type} offset=${box.offset} size=${box.size}`;
      const children = box.children
        ? "\n" + printBoxTree(box.children, indent + 2)
        : "";

      return line + children;
    })
    .join("\n");
}
使用:
const buffer = await file.arrayBuffer();
const view = new DataView(buffer);
const tree = parseBoxes(view, 0, buffer.byteLength);

console.log(printBoxTree(tree));
输出可能是:
ftyp offset=0 size=32
moov offset=32 size=38210
  mvhd offset=40 size=108
  trak offset=148 size=19100
    tkhd offset=156 size=92
    mdia offset=248 size=19000
      mdhd offset=256 size=32
      hdlr offset=288 size=45
      minf offset=333 size=18915
        vmhd offset=341 size=20
        dinf offset=361 size=36
        stbl offset=397 size=18851
          stsd offset=405 size=171
          stts offset=576 size=24
          stss offset=600 size=1024
          stsc offset=1624 size=40
          stsz offset=1664 size=12020
          stco offset=13684 size=5572
  trak offset=19248 size=18994
mdat offset=38242 size=10293833
这个练习非常值。因为你一旦能把 box tree 打出来,MP4 就不再是黑盒了。
34. 面试题和参考答案
问题 1:MP4 里的 box / atom 是什么?
参考回答:
MP4 是基于 ISO BMFF 的 box 结构文件。box 也叫 atom,每个 box 通常由 size、type 和 payload 组成。type 是四字符标识,比如
ftyp、moov、mdat。有些 box 是容器,可以继续包含子 box,比如moov、trak、mdia、minf、stbl。播放器通过解析这些 box 获得文件类型、轨道信息、时间戳、sample 大小和媒体数据偏移。
问题 2:moov 和 mdat 有什么区别?
参考回答:
moov是元数据容器,包含 movie header、track 信息、sample table、codec 初始化信息等。mdat是媒体数据容器,里面放压缩后的音视频 sample。播放器通常先解析moov,通过stbl中的 sample table 找到 sample 的时间、大小和文件偏移,再去mdat里读取对应字节送给 decoder。
问题 3:为什么 moov 在文件末尾会影响在线播放?
参考回答:
因为播放器播放前需要先拿到
moov里的 sample 索引和 codec 信息。如果moov在mdat后面,网络播放时可能需要先请求文件尾部,或者等待更多数据下载完成。fast start MP4 会把moov放到mdat前面,让播放器尽早拿到索引,从而支持更快起播。移动moov后还要修正stco或co64里的 chunk offset。
问题 4:stbl 里面有哪些关键 box?
参考回答:
stbl是 sample table,核心 box 包括:stsd描述 codec 和初始化参数;stts描述 sample 的解码时间;ctts描述显示时间偏移;stsc描述 sample 到 chunk 的映射;stsz描述每个 sample 的大小;stco或co64描述 chunk 在文件中的偏移;stss描述同步 sample,也就是关键帧或随机访问点。
问题 5:播放器如何通过 MP4 找到某一帧视频?
参考回答:
先通过
trak和hdlr找到视频轨,再进入stbl。用stts和ctts计算目标时间附近的 sample,用stss找到最近关键帧,用stsc判断 sample 属于哪个 chunk,用stco/co64找到 chunk 的文件偏移,用stsz累加得到 sample 在 chunk 内的位置和大小。然后从mdat读取这段字节,结合stsd中的 codec 配置送给视频 decoder。
问题 6:普通 MP4 和 fragmented MP4 有什么区别?
参考回答:
普通 MP4 通常是
ftyp + moov + mdat,完整 sample table 通常集中在moov里。fragmented MP4 则是ftyp + moov + moof/mdat...,初始化信息在moov,每个 fragment 的 sample 信息在对应的moof中,媒体数据在对应的mdat中。fMP4 更适合 MSE、DASH、HLS fMP4 这类分段传输场景。
35. 自测题
题 1:ftyp 的作用是什么?
答案:
ftyp 用来声明文件类型、major brand、minor version 和 compatible brands。播放器可以通过它判断当前文件属于哪类 MP4 / ISO BMFF 变体,以及是否可能支持该文件。
题 2:为什么只有 mdat 不够播放?
答案:
因为 mdat 主要放压缩后的媒体数据,不负责完整描述 sample 的边界、时间戳、大小、codec 信息、关键帧位置和文件偏移。播放器需要 moov 里的 stbl 等索引信息才能正确切分和解码 mdat 里的数据。
题 3:stco 和 co64 的区别是什么?
答案:
stco 使用 32-bit offset 记录 chunk 文件偏移,co64 使用 64-bit offset。大文件可能超过 4GB,32-bit offset 不够,所以需要 co64。
题 4:fast start MP4 的核心原理是什么?
答案:
把 moov 移到 mdat 前面,让播放器在文件开头就能获得元数据和 sample 索引,从而更快开始播放。移动后需要修正 stco 或 co64 中的 chunk offset。
题 5:fMP4 中 moof 和 mdat 的关系是什么?
答案:
moof 描述一个 fragment 的元数据,比如 sample 的时长、大小、flags、时间起点和数据偏移;紧随其后的 mdat 放这个 fragment 对应的媒体数据。浏览器 MSE 常见结构是初始化段 ftyp + moov,媒体段 moof + mdat。
36. 本章总结
这一章你需要牢牢记住这几句话:
MP4 是 box / atom 结构。ftyp 说明文件类型和兼容性。moov 是播放地图,mdat 是媒体数据仓库。trak 表示一条逻辑媒体轨道,比如视频轨或音频轨。stbl 是 sample 索引核心,播放器靠它找到 sample 的时间、大小、位置和关键帧。fast start MP4 的关键是 moov 在 mdat 前。fragmented MP4 的关键是 init segment + moof/mdat media segments。掌握这些后,你再看 WebCodecs、MSE、HLS fMP4、DASH,就不会觉得它们像黑魔法了。很多播放问题,本质上都是:
容器结构不对
codec 信息不对
sample 索引不对
timestamp 不对
offset 不对
关键帧不对
37. 下一章衔接:MP3 内部结构
下一章会学习 MP3。
你会发现 MP3 和 MP4 很不一样:
MP4 更像“复杂容器 + 索引 + 媒体数据”
MP3 更像“标签 + 连续音频帧流”
下一章重点会讲:
- ID3 标签是什么。
- MP3 frame header 怎么看。
- CBR 和 VBR 有什么区别。
- 为什么 MP3 seek 有时不准。
- 怎么用浏览器读取 MP3 前几个 frame。
- 如何写一个最小 MP3 frame header parser。